
Depuis le 30 octobre 2026, trois lignes dans le fichier robots.txt de votre site suffisent pour dire à plusieurs éditeurs d’IA, d’un coup : « n’entraînez pas vos modèles avec mon contenu ». Anthropic l’applique déjà, Microsoft l’adopte pour Bing, Google le prendra en compte début 2027.
Sur adtg.fr, nous ne l’ajouterons pas. Voici ce que fait ce signal, ce qu’il ne fait pas, pourquoi nous laissons les IA lire notre site, et dans quels cas nous conseillons l’inverse à nos clients.
Un seul signal pour plusieurs IA
Jusqu’ici, refuser l’entraînement des IA demandait une règle par robot : une pour celui d’OpenAI, une pour celui d’Anthropic, une pour celui de Google, et ainsi de suite, en espérant n’oublier personne. Le nouveau signal regroupe tout sous un nom commun, que chaque éditeur qui l’adopte s’engage à lire.
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
La première ligne vise l’entraînement des IA en général, et non un robot précis. La deuxième refuse l’entraînement sur tout le site. La troisième, facultative, laisse une partie en accès, ici un dossier de presse.
Prudence sur le statut, quand même. C’est un brouillon déposé à l’IETF, l’organisme qui normalise les protocoles d’internet, le 30 octobre 2026, par un ingénieur d’Anthropic. Il n’a pas été adopté à ce jour, et sa forme peut encore changer (brouillon IETF).
Qui le respecte, et à partir de quand
Au 7 novembre 2026, un seul éditeur l’applique déjà. Les autres l’annoncent, ou ne l’ont pas encore documenté.
| Éditeur | Où il en est | En attendant |
|---|---|---|
| Anthropic (Claude) | Appliqué depuis le 30/10/2026 (aide Anthropic) | Une règle qui vise nommément son robot reste prioritaire |
| Google (Gemini) | Prévu « début 2027 » (doc Google) | La règle Google-Extended reste celle qui compte |
| Microsoft (Bing, Copilot) | Adopté, avec en plus des réglages page par page (blog Bing) | Calendrier de mise en place jusqu’en 2027 |
| OpenAI (ChatGPT) | Participation rapportée par la presse, absente de sa documentation | La règle GPTBot reste celle qui compte |
| Perplexity | Absent de sa documentation | Rien de nouveau |
En pratique, ce signal ne remplace rien pour l’instant. Il s’ajoute aux règles par robot, qu’il ne faut surtout pas retirer.
Ce que ce signal ne fait pas
Il ne vise que l’entraînement des modèles. C’est le malentendu à éviter, parce qu’on peut vite croire qu’on se retire « des IA » en général.
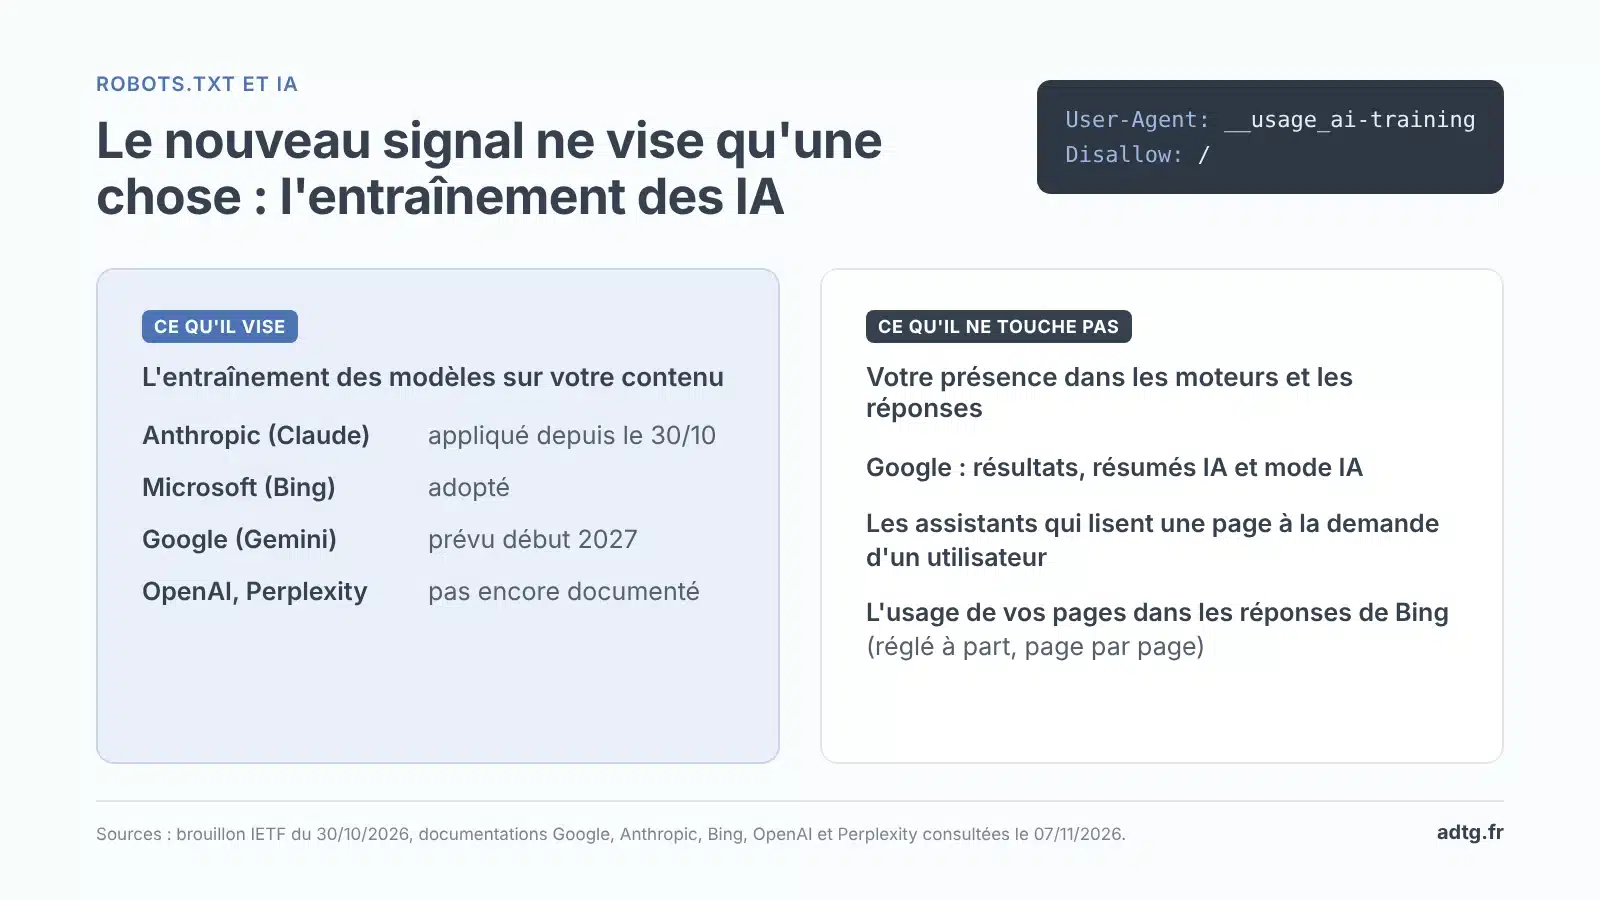
Il ne vous retire pas de Google. Ni des résultats classiques, ni des résumés générés par IA en haut de page, ni du mode IA de Google. Pour sortir de ces réponses-là, il existe un autre réglage, dans la Search Console, qui ne joue pas sur le classement (aide Google). On le déconseille à presque tous nos clients : c’est se rendre invisible là où leurs prospects posent désormais leurs questions.
Il n’arrête pas les assistants qui lisent une page à la demande. Quand quelqu’un demande à ChatGPT ou à Perplexity de consulter votre site, la visite part d’un humain. Leurs éditeurs précisent que ces robots-là peuvent ne pas appliquer le robots.txt (OpenAI, Perplexity).
Il ne règle pas l’usage dans les réponses. Bing traite ça à part, page par page, avec de nouvelles balises. Et pour les sites qui comptaient sur les anciennes balises « noarchive » ou « nocache » pour se protéger de Copilot, il y a une date à retenir : après le 1er mars 2027, Bing ne les lira plus comme une préférence d’entraînement ou de réponse (blog Bing).
Notre choix pour adtg.fr, et quand nous conseillons l’inverse
Le robots.txt d’adtg.fr n’interdit qu’une chose : l’accès à l’administration du site. Tous les robots d’IA peuvent lire le reste, y compris pour s’entraîner. C’est un choix, pas un oubli.
Notre site est une vitrine. Ce que nous y écrivons est fait pour être lu, repris, cité, et nous n’avons rien à y protéger qui se vendrait. Soyons honnêtes aussi sur ce que nous ne savons pas : rien ne démontre qu’autoriser l’entraînement fasse davantage citer un site par les IA. Nous ne le faisons pas pour ça. Nous le faisons parce que l’interdire ne nous rapporterait rien.
Le raisonnement s’inverse quand le contenu du site est le produit lui-même. Une formation payante, une étude, un guide vendu, une banque de photos originales, un site d’information dont c’est le métier : là, laisser un modèle apprendre gratuitement ce que vous vendez mérite réflexion. Pour ces clients-là, voici ce que nous faisons :
- on ajoute le nouveau signal en plus des règles par robot déjà en place, jamais à leur place ;
- on laisse passer les robots qui servent à la recherche, ceux qui permettent à ChatGPT, Claude ou Perplexity de trouver et citer le site, pour ne pas disparaître de leurs réponses ;
- on repère les anciennes balises « noarchive » et « nocache », à remplacer avant le 1er mars 2027.
Que dit le robots.txt de votre site ? On le relit avec vous pendant l’appel découverte gratuit de 30 minutes. Réserver un créneau